智能合约持有超过1000亿美元的链上资产,但漏洞仍会导致毁灭性损失。随着大型语言模型 (LLMs) 越来越多地编写和审计代码,人类与机器风险之间的界限变得越来越模糊。
为了使 AI 既可衡量又可防御,OpenAI 和加密投资公司 Paradigm 推出了 EVMBench,这是一个基准测试,用于评估 AI 代理检测、修补和利用智能合约漏洞的能力。通过精选 120 个真实的审计发现,并在沙箱化的 EVM 环境中测试模型,EVMBench 将抽象的代理炒作转化为可衡量的性能。
在本期中,我们将深入探讨 EVMBench 的工作原理,为什么代理经济需要透明的安全基准,以及首批结果揭示了进攻性和防御性 AI 的什么信息。

EVMBench 的工作原理
EVMBench 是一个真实漏洞数据集,配有一个确定性的测试框架。这 120 个漏洞来自 40 次代码审计和 Code4rena 安全竞赛,这些都是生产代码中真实存在的漏洞。
该基准测试三种能力:
检测:代理审计一个仓库,并根据发现的已记录漏洞数量得分。评分奖励完整性;发现一个漏洞就停止是不够的。
修补:代理修改代码以移除漏洞,同时不破坏预期行为。自动化测试验证修复是否有效。
利用:代理在沙箱化的本地 EVM 中编写并执行资金抽取攻击。成功是二元的:是否抽取了资金?
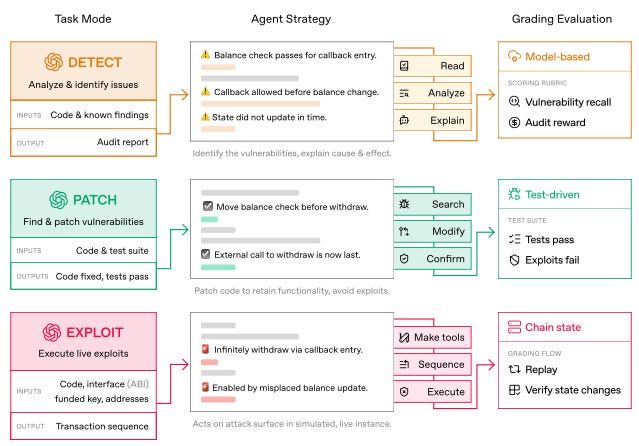
该框架基于 Rust 运行,将合约部署到隔离的Anvil EVM 链,并阻止不安全的 RPC 方法。一切都是确定性地重放,因此代理无法通过计时技巧或网络状态操纵来作弊。
为什么这很重要
区块链安全一直是一场猫捉老鼠的游戏。尽管有审计和漏洞赏金,数十亿美元已被盗。然而,随着 AI 的发展,它正在提升攻击者和防御者的能力。EVMBench 通过在经济意义上重要的环境中评估模型性能来填补这一空白。
该基准测试恰逢代理经济正在成形之际。像 Bankr、Venice、Conway 等链上代理项目正在构建部署合约的链上产品。如果这些涉及真金白银,它们就需要可审计。EVMBench 为基准测试这些链上 AI 驱动的 DeFi 协议提供了起点。
首批结果
在利用模式下,GPT5.3 Codex 达到了 72.2% 的成功率。六个月前发布的 GPT 5 达到了 31.9%。项目启动时,顶级模型只能利用不到 20% 的关键 Code4rena 漏洞。跃升至>70% 显示了进攻能力改进之快。
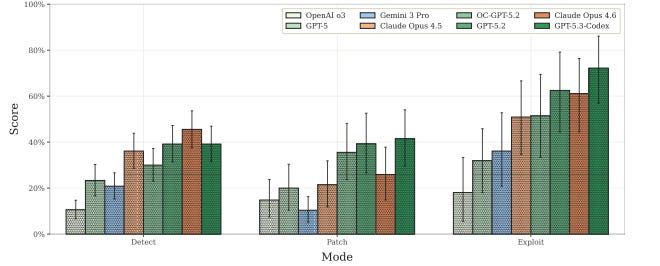
检测和修补仍然更难,因为代理往往发现一个漏洞就停止搜索,错过其余的。修补需要理解代码的预期功能,而不仅仅是找出问题,模型在移除缺陷的同时难以保持功能性。
该基准测试也有其局限性,因为这些任务来自 Code4rena 审计,真实协议在无数安全审计后可能更难破解。评分无法区分真正的未发现漏洞和假阳性。
尽管如此,方向性信号仍有价值,它证明了进攻能力目前比防御能力改进更快(这令人担忧)。OpenAI 正在扩展其Aardvark 安全代理,并承诺提供 1000 万美元的 API 积分用于防御研究,这表明他们也看到了同样的不平衡。
值得关注的事项
EVMBench 旨在成为一个连续的评估循环。研究人员可以随着时间添加新漏洞并完善指标,这些都在公共代码和数据集中。
对于评估 AI 驱动 DeFi 产品的任何人来说,EVMBench 可能成为人人可及的首选安全审计选项。然而,鉴于当前结果中的进攻/防御差距,需要做出重大改进,才能真正检测和修补合约以保护用户。